

Как создать веб‑приложение для фичефлагов и раскаток
Пошаговый план, как спроектировать и собрать веб‑приложение для фичефлагов: модели данных, UI, API, правила раскатки, аудит, безопасность и наблюдаемость.
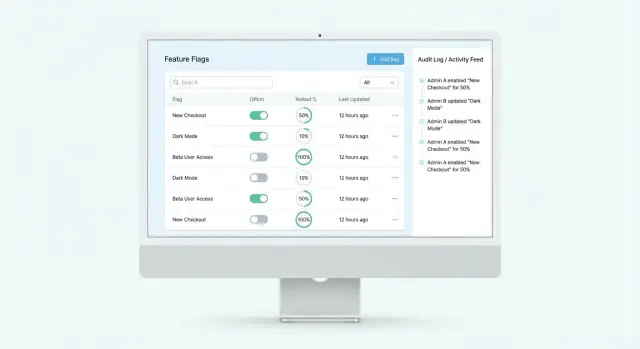
Что такое фичефлаги и раскатки — простыми словами
Фичефлаг (feature flag) — это переключатель, который позволяет включать или выключать часть функциональности без повторного релиза приложения. Проще говоря, код новой фичи уже может быть в продакшене, но пользователи увидят её только тогда, когда вы «поднимете флаг».
Важно не путать фичефлаги с обычной конфигурацией. Конфигурация — это параметры работы уже существующей логики (например, «таймаут 5 секунд» или «цвет кнопки»). Фичефлаг же управляет тем, выполняется ли вообще ветка логики: показывать ли новый экран, запускать ли новый алгоритм, отправлять ли запрос в новый сервис.
Зачем нужны раскатки (rollout)
Раскатка — это не просто «включить/выключить», а включать постепенно и по правилам. Это снижает риск: вы даёте новой функциональности маленькую аудиторию, смотрите на метрики и только потом расширяете охват.
Что это даёт на практике:
- Снижение риска: если что-то пошло не так, пострадает 1–5% пользователей, а не все.
- Быстрый откат: вы выключаете флаг (kill switch) и останавливаете проблему за минуты, не дожидаясь хотфикса и публикации.
- Тестирование гипотез: A/B‑тестирование и сравнение вариантов (например, новый/старый алгоритм) с измеримыми результатами.
Типичные сценарии использования
Самые частые правила включения выглядят так:
- По проценту пользователей: 10% → 25% → 50% → 100%.
- По группам: только сотрудники, бета‑тестеры, отдельные клиенты, пользователи с определённым тарифом.
- По окружениям: в dev/stage включено всем, в production — ограниченно или выключено.
Почему нужен отдельный сервис флагов
Если флаги «живут» в коде, в переменных окружения или в таблице базы данных без правил и аудита, команда быстро сталкивается с хаосом: непонятно, кто и когда что поменял, как безопасно трогать продакшен и почему у разных сервисов «разные версии правды».
Отдельный сервис фичефлагов решает это системно: даёт единое место управления, одинаковые правила раскатки для всех приложений, быстрый kill switch, историю изменений и понятный процесс для команды.
Требования и границы проекта: MVP и что важно заранее
Прежде чем рисовать интерфейс и писать API, полезно договориться о границах системы фичефлагов: кто ею пользуется, какие операции обязательны, и какие «неочевидные» требования важнее всего. Это экономит недели, потому что фичефлаги почти сразу становятся критичной частью релизного процесса.
Роли и сценарии: кто что делает
Минимальный набор ролей обычно выглядит так:
- Разработчик — создаёт флаг, добавляет варианты, проверяет поведение в тестовых окружениях.
- Менеджер продукта — управляет раскатками и правилами, анализирует эффект, инициирует откат.
- Поддержка — может быстро выключить проблемную функцию (kill switch) по инструкции.
- Администратор — управляет доступами, окружениями, политиками безопасности.
Под эти роли стоит сразу перечислить ключевые операции: создать флаг, включить/выключить, настроить правила/раскатку, посмотреть историю изменений. Даже в MVP важно, чтобы каждое действие было понятно, обратимо и оставляло след в аудите.
Нефункциональные требования: о чём часто забывают
Фичефлаги читаются гораздо чаще, чем меняются — поэтому требования к runtime‑части обычно жёстче, чем к админке.
- Задержка: получение значений флагов не должно заметно замедлять приложение (ориентир — миллисекунды на путь выполнения).
- Отказоустойчивость: если сервис флагов недоступен, приложение должно продолжить работать по понятной стратегии (кэш, дефолты, «последнее известное значение»).
- Безопасность: доступ к продакшен‑настройкам и особенно к kill switch должен быть ограничен, с MFA/SSO при необходимости.
Ограничения: цифры, без которых архитектура «плывёт»
Зафиксируйте хотя бы приблизительно:
- Сколько сервисов и окружений (dev/stage/prod, регионы, отдельные инсталляции).
- Сколько флагов ожидается через 3–6 месяцев (десятки, сотни, тысячи).
- Частота чтения: сколько запросов в секунду к runtime и нужен ли SDK с локальным кэшем.
Эти оценки влияют на хранение, кэширование, формат доставки (пуш/пулл) и стоимость эксплуатации.
Как определить MVP
Для первой версии обычно достаточно:
- Базовых типов: boolean (вкл/выкл) и multivariate (варианты).
- Простых правил: «всем/никому», процентная раскатка, включение по списку пользователей.
- Минимального UI: список флагов, карточка флага, переключатель, форма правил, страница истории.
Главное — чтобы MVP уже позволял безопасно управлять релизным риском: быстро выключить функцию, понять кто и когда менял настройки, и не зависеть от ручных правок конфигов.
Отдельная практичная опция для старта — собрать MVP на TakProsto.AI: админку на React, runtime‑сервис на Go и хранение правил в PostgreSQL можно быстро набросать в формате чата, а затем развернуть, подключить домен и при необходимости экспортировать исходники. Это удобно, если хотите быстро провалидировать UI/модель данных и перейти к промышленной реализации без «выбрасывания» прототипа.
Модель данных: флаги, окружения, правила и варианты
Хорошая система фичефлагов держится на понятной модели данных: она должна быть достаточно гибкой для реальных раскаток, но не превращаться в «конфигурационный комбайн», который трудно поддерживать.
Базовые сущности: проект, окружение, флаг
Обычно хватает трёх уровней:
- Project (Приложение) — логическая единица, в рамках которой живут флаги (например, «web‑app» или «mobile‑api»).
- Environment (Окружение) — отдельные настройки для dev/stage/prod. Важно, чтобы правила в продакшене не «подхватывались» случайно из тестовых сред.
- FeatureFlag (Флаг) — собственно переключатель: ключ (например,
new_checkout), описание, владелец/команда, ссылки на задачу.
На практике удобно хранить значения и правила на уровне окружения, потому что раскатка почти всегда отличается между stage и prod.
Варианты флагов: boolean, multivariate, JSON
Тип флага лучше фиксировать явно:
- Boolean — включено/выключено. Самый безопасный и понятный вариант, идеален для kill switch.
- Multivariate — несколько вариантов (например,
control,v1,v2) для A/B‑тестирования или постепенной замены алгоритма. - JSON — оправдано, когда нужно передавать параметризацию (например, лимиты, таймауты, набор экспериментов). Минус: сложнее валидировать и контролировать изменения, поэтому стоит добавлять схему/валидацию и ограничения на размер.
Правила таргетинга: кому показать
Правило обычно описывается как «если… то…»:
- по пользователю (конкретные ID для точечного включения),
- по группе (например, внутренние сотрудники или бета‑тестеры),
- по атрибутам (страна, тариф, платформа, версия приложения).
Хорошая практика — отделить условия (предикаты по атрибутам) от результата (какое значение/вариант выдаём).
Раскатка по проценту: стабильное распределение (sticky)
Процентная раскатка должна быть стабильной: один и тот же пользователь не должен «прыгать» между включено/выключено.
Для этого используют хэш от пары (flag_key + user_id) и сравнивают его с порогом процента. Тогда при 10% один и тот же набор пользователей будет попадать в эти 10% независимо от времени и количества запросов.
Версионирование и статусы: draft/active/archived
Чтобы изменения были управляемыми, добавьте жизненный цикл:
- draft — подготовка и проверка на stage,
- active — используется в окружении,
- archived — скрыт из основных списков, не участвует в выдаче.
Плюс полезно хранить версию/ревизию правил (например, автоинкремент при каждом изменении). Это облегчает аудит, откаты и воспроизводимость: «какие правила действовали вчера в 14:00».
UI для управления: как сделать панель понятной и безопасной
Хороший UI для фичефлагов — это не «красивый список переключателей», а рабочее место, где ошибки стоят дорого. Цель панели — помочь человеку быстро понять контекст, уверенно внести изменение и не сломать продакшен случайным кликом.
Главный экран: быстро найти нужное
Начните с панели, где флаги легко просматриваются и фильтруются. Важно, чтобы список не превращался в свалку:
- поиск по ключу и названию (с подсказками и терпимостью к опечаткам);
- фильтры по окружению (dev/stage/prod) и тегам (например: billing, onboarding);
- явные статусы: включён, выключен, в раскатке, «аварийный выключатель».
Полезная деталь: показывайте краткую сводку прямо в строке — текущие правила, процент раскатки, дату последнего изменения.
Карточка флага: контекст важнее тумблера
В карточке флага сделайте обязательными поля, которые предотвращают «безымянные переключатели»:
- понятное описание «что делает» и «как откатить»;
- владелец (команда/человек) и контакты;
- ссылки на задачу и документацию (внутренние страницы/вики).
Добавьте историю изменений внизу карточки: кто менял, что именно и в каком окружении.
Редактор правил: меньше магии, больше прозрачности
Правила таргетинга должны читаться как текст, а не как формула. Используйте «конструктор условий» с человеческими подписями и примерами значений.
Ключевая функция — предпросмотр «кто попадёт»: пользователь вводит пример идентификатора/атрибутов, а UI объясняет, почему правило сработало (или нет). Это резко снижает риск неверных условий.
Защита от ошибок: продакшен — особый режим
Для опасных действий добавьте предохранители:
- отдельные подтверждения для prod (вплоть до ввода названия флага);
- заметные баннеры «Вы в prod» и цветовую маркировку окружений;
- предупреждения при изменении глобальных правил и kill switch.
Дашборд активности: видеть, что происходит
Сделайте отдельный экран активности: последние изменения, популярные флаги по обращениям, алерты (например, слишком частые правки или всплеск выключений). Такой дашборд помогает заметить проблемы раньше, чем их увидят пользователи.
Архитектура и API: админка, runtime‑сервис и доставка флагов
В системе фичефлагов обычно живут два разных мира: админский (где люди настраивают правила) и runtime (где приложения быстро получают готовый ответ «включено/выключено/какой вариант»). Если смешать их в один сервис и один API, вы быстро упрётесь в проблемы с производительностью и безопасностью.
Два контура: admin vs runtime
Admin‑контур делает много записей, требует валидаций и прав доступа. Runtime‑контур — это почти всегда чтение, высокая частота запросов, минимальная задержка и предсказуемая нагрузка.
Практичный вариант: одна база/хранилище правил + два сервиса (или два набора эндпоинтов) с разными политиками доступа и масштабирования.
API для админки: CRUD и управление моделями
Админское API обычно покрывает:
- CRUD флагов (создать/изменить/архивировать), описание, owner, ссылки на задачу.
- Окружения (dev/stage/prod) и параметры по умолчанию.
- Правила таргетинга/раскатки и варианты (для A/B).
- Теги/папки для навигации и поиска.
Важно: любые изменения в продакшене должны проходить через авторизацию, аудит и, по возможности, «двухэтапность» (черновик → публикация).
Runtime API для клиентов: быстрый эндпоинт
Runtime‑эндпоинт должен быть простым и быстрым, например:
GET /runtime/v1/flags?env=prod&app=myapp
Он возвращает готовый результат вычисления (или предвычисленные данные), а не «сырые» правила. Контекст запроса (например, userId, country) можно передавать заголовками или в теле — это зависит от выбранной модели вычисления и требований к кешированию.
Доставка: pull и streaming
Есть две стратегии:
- Pull: SDK периодически запрашивает флаги (каждые N секунд). Это проще и надёжнее, хорошо переживает сбои сети.
- Streaming (SSE/WebSocket): сервер пушит изменения почти мгновенно. Это полезно для быстрых kill switch и активных экспериментов, но сложнее в эксплуатации.
Часто делают гибрид: streaming как «ускоритель», pull как запасной путь.
Кеширование: меньше трафика, быстрее ответы
Базовый набор:
ETag+If-None-Matchдля ответа runtime (304 Not Modified вместо полного payload).- TTL на стороне CDN/edge (если контекст не пользовательский) или на стороне сервиса.
- Локальный кеш в SDK (в памяти + опционально на диске), чтобы переживать временную недоступность runtime.
Формат ответа: минимум полей + версия схемы
Держите ответ компактным и стабильным:
- только ключ → значение (и/или вариант), без админских метаданных;
- отдельное поле
schemaVersionи/илиflagsVersion(монотонный номер/хеш), чтобы удобно сравнивать и отлаживать; - одинаковая структура для всех платформ, чтобы SDK были простыми.
Чем меньше «лишнего» вы отправляете в runtime, тем проще масштабировать систему и тем безопаснее она для продакшена.
Правила таргетинга и раскаток: от сегментов до kill switch
Фичефлаг ценен не тем, что «включает/выключает», а тем, что умеет включаться для нужных пользователей и в нужный момент. Поэтому правила таргетинга и раскатки — сердце системы: здесь чаще всего появляются ошибки и «сюрпризы».
Роутинг по атрибутам: кому показываем
В рантайме вы почти всегда решаете один вопрос: попадает ли пользователь под правило? Для этого у сущности «контекст» (user/org/request) должны быть атрибуты, по которым можно фильтровать:
- email‑домен (например,
@company.ru) — удобно для пилотов с конкретными заказчиками; - организация/tenant — самое частое в B2B: включаем по
org_id; - платный план — Pro/Enterprise‑функции;
- регион — иногда важно из‑за законодательства, интеграций или инфраструктуры.
Практика: заранее зафиксируйте «словарь атрибутов» и их типы (строка/число/список). Так UI сможет валидировать правила, а SDK — корректно отправлять контекст.
Группы и сегменты: вручную и по правилам
Сегменты обычно бывают двух типов:
- ручные списки: «10 конкретных org_id для пилота» — быстро, но требует дисциплины;
- динамические правила: «все организации с планом Enterprise в регионе EU» — меньше ручной работы, но выше риск случайно расширить охват.
Хорошая панель управления показывает оценку размера сегмента (примерно сколько пользователей/организаций попадёт) и даёт предпросмотр: «проверить конкретного пользователя по ID».
Приоритеты и дефолт: чтобы не было сюрпризов
Правила почти всегда пересекаются. Нужны понятные и стабильные приоритеты:
- сначала явные исключения (deny/allow list),
- затем сегменты пилота,
- затем процентная раскатка,
- в конце — дефолтное значение.
Дефолт должен быть очевиден в UI и API (например, off), иначе при удалении правила можно случайно «включить всем».
Процентная раскатка: равномерность, воспроизводимость, липкость
Процентная раскатка должна быть:
- равномерной (похожа на честные 5%, 10%, 25%);
- воспроизводимой: один и тот же пользователь сегодня и завтра получает одинаковый результат;
- «липкой»: пользователь не «мигает» между вариантами при каждом запросе.
Обычно это делается через детерминированный хэш от (flag_key + stable_id) и сравнение с порогом. Важно выбрать стабильный идентификатор (user_id или org_id), иначе после миграций/логинов доля «поплывёт».
Kill switch: мгновенное отключение без деплоя
Kill switch — отдельный быстрый рубильник, который перекрывает все правила и принудительно возвращает безопасное значение (обычно off).
Ключевые требования: действие должно применяться за секунды, быть заметным в UI (яркий статус) и обязательно фиксироваться в аудите: кто, когда и почему отключил. Это ваш план «Б», когда метрики упали, а раскатывать фикс релизом некогда.
Безопасность, роли и аудит: кто может менять продакшен
Фичефлаги влияют на поведение продакшена «на лету», поэтому безопасность здесь — не опция, а базовая функция продукта. Хорошая новость: большинство рисков закрываются простыми правилами и несколькими обязательными механизмами.
Аутентификация: люди и сервисы
Для пользователей панели управления обычно достаточно SSO (SAML/OIDC) или логина по паролю с MFA. Главное — единый способ входа и централизованное отключение доступа при увольнении.
Для runtime‑сервисов и SDK нужны отдельные токены (API keys), которые:
- выдаются на конкретный проект/окружение;
- имеют срок жизни или возможность ротации;
- можно быстро отозвать (особенно при утечке).
Авторизация (RBAC): кто и что может
RBAC стоит строить вокруг окружений и типов действий. Минимальный набор ролей:
- Viewer — только просмотр;
- Editor (dev/stage) — правки вне продакшена;
- Release manager — запуск раскаток в prod;
- Admin — управление ролями, токенами, настройками.
Отдельно продумайте права на «опасные» операции: включение kill switch, изменение правил таргетинга, массовые правки.
Аудит: доказуемость изменений
Аудит должен отвечать на вопросы кто/что/когда и что именно изменилось:
- запись пользователя/сервиса, IP/клиент, время, окружение;
- дифф конфигурации до/после;
- поле «причина изменения» (обязательное для prod), чтобы потом не гадать.
Полезно уметь фильтровать события и быстро восстанавливать предыдущее значение (rollback) на основе истории.
Защита от ошибок: подтверждение и ревью
Чтобы один клик не «уронил» релиз, добавьте:
- двухэтапное подтверждение для prod (например, ввод имени флага или тикета);
- режим «требуется ревью»: изменения в prod вступают в силу только после подтверждения второй ролью (принцип «четыре глаза»);
- безопасные ограничения (например, запрет ставить 100% rollout без дополнительного подтверждения).
Секреты и чувствительные данные
Не храните секреты в значениях флагов: ни токены, ни пароли, ни ключи API. Фичефлаг — это про поведение, а не про секретное хранилище. Для чувствительных данных используйте отдельный vault/секрет‑менеджер, а во флагах держите лишь идентификаторы или переключатели.
Клиентские SDK и интеграция в приложения
Клиентские SDK — это «проводник» между вашим приложением и сервисом фичефлагов. От их качества зависит, будут ли флаги удобны разработчикам и безопасны для пользователей: SDK должен работать быстро, предсказуемо и не ломать приложение при сбоях.
Требования к SDK: API, кеш, таймауты, fallback
Минимальный набор — простой API вроде isEnabled(flagKey, context) и getVariant(flagKey, context). Хорошая практика — возвращать детерминированный результат (boolean/variant) и опционально — причину (из кеша, по умолчанию, по правилу).
Критично иметь:
- Кеш (в памяти + опционально на диске/в local storage), чтобы не дергать сеть на каждый запрос.
- Таймауты на запросы к runtime‑сервису (например 100–300 мс на фронтенде, 300–800 мс на бэкенде).
- Fallback: если флаг не найден или правило некорректно, возвращайте безопасное значение по умолчанию.
Идентификация пользователя: userId, anonymous id, device id
Для таргетинга и раскаток SDK должен уметь работать с несколькими идентификаторами:
userId— для авторизованных пользователей.anonymousId— для гостя (генерируется и хранится локально).deviceId— полезен на мобильных, но используйте осторожно.
Важно: один и тот же пользователь не должен «прыгать» между вариантами. Поэтому при наличии userId именно он должен быть основным ключом для хеширования раскатки.
Сбор контекста: без лишних данных
Контекст — это атрибуты, по которым вы делаете правила: версия приложения, платформа, страна, тариф, внутренний сотрудник/нет. Собирайте только то, что реально участвует в правилах, и заранее определите схему: какие поля допустимы, какие типы (строка/число/булево), какие ограничения.
Недоступность сервиса: кеш и деградация
Если runtime‑сервис недоступен, SDK должен:
- использовать последний успешный кеш;
- при отсутствии кеша — применять дефолты;
- не блокировать пользовательский поток (никаких «ожиданий флагов» в критичных местах).
Примеры интеграции (концептуально)
- Backend: инициализируйте SDK при старте, обновляйте кеш в фоне, прокидывайте контекст из сессии/токена.
- Frontend: загружайте «снимок флагов» один раз при старте страницы, обновляйте по таймеру или при логине.
- Мобильные: храните кеш на диске, делайте ленивую синхронизацию, учитывайте режим офлайн.
Наблюдаемость: метрики, события, логи и алерты
Фичефлаги влияют на поведение продукта так же сильно, как и релизы. Поэтому для них нужна наблюдаемость: понимать, что именно включено, кому показывается, и не стало ли хуже после изменения.
Метрики флагов
Начните с базового набора метрик, которые собираются автоматически из runtime‑сервиса и SDK:
- Количество оценок флага (evaluations): сколько раз приложение «спрашивало» значение флага. Это помогает увидеть популярные флаги и неожиданные всплески.
- Распределение вариантов: доли по вариантам (on/off или multi‑variant). Важно для постепенной раскатки и A/B‑тестирования.
- Ошибки: таймауты получения конфигурации, ошибки парсинга, фолбэки на дефолт, несовпадение версий. Отдельно полезно считать долю запросов, где флаг оценён «по умолчанию» из‑за проблем с доставкой.
Метрики стоит срезать по окружению (dev/stage/prod), приложению/сервису, версии релиза и, при необходимости, по сегментам пользователей (в обезличенном виде).
События: что изменилось и когда
Помимо метрик нужны события управления (audit events): включение/выключение, изменение правил таргетинга, изменение процента раскатки, публикация в prod, откат. В событии фиксируйте «кто/что/когда» и контекст: окружение, имя флага, предыдущие и новые значения.
{
  "type": "flag.published",
  "flagKey": "new_checkout",
  "env": "prod",
  "actor": "ivan.petrov",
  "from": {"rollout": 10},
  "to": {"rollout": 50},
  "release": "2025.12.3",
  "timestamp": "2025-12-26T10:15:00Z"
}
Логи и трассировка
Логи помогают отвечать на вопрос «почему конкретному запросу показали именно так». Добавляйте в логи корреляционный id запроса, версию конфигурации и итог оценок ключевых флагов (без персональных данных). Если используете распределённую трассировку — прикрепляйте эти же атрибуты к спанам, чтобы связывать изменения флагов с деградациями.
Алерты, которые реально спасают
Полезные правила оповещений:
- Резкий рост ошибок/латентности после включения флага (по времени и по версии релиза).
- Скачок фолбэков: runtime недоступен, конфиг не обновляется.
- «Флаг включён в prod слишком долго»: напоминание удалить временный флаг или зафиксировать решение.
Экспорт данных в аналитику
Сразу продумайте экспорт метрик и событий в вашу систему аналитики: пакетная выгрузка (например, по расписанию) или потоковая доставка. Важно сохранить единые идентификаторы (flagKey, env, release), чтобы потом удобно строить отчёты: «какие флаги чаще всего меняют», «какие изменения приводили к инцидентам», «какие эксперименты завершены, но флаги не убраны».
Тестирование и эксплуатация: чтобы флаги не ломали релизы
Фичефлаги часто воспринимают как «конфиг», который можно менять без риска. На практике это продакшен‑код и продакшен‑данные: ошибка в правилах или деградация runtime‑сервиса способна остановить выпуск так же, как падение API. Поэтому тестирование и эксплуатацию нужно закладывать в дизайн системы с самого начала.
Тестирование правил: логика важнее UI
Самое хрупкое место — вычисление итогового значения флага. Для него стоит выделить отдельный модуль (policy engine) и покрыть юнит‑тестами:
- Приоритеты: что выигрывает — kill switch, правило для пользователя, сегмент, процентная раскатка, дефолт.
- Границы процентов: 0%, 100%, округление, стабильность хэша (чтобы пользователь не «прыгал» между вариантами).
- Сегменты: пустой сегмент, пересечения, большие списки, неизвестные атрибуты.
Полезный приём — «табличные» тесты: набор входных атрибутов + ожидаемое решение. Так проще ловить регрессии при добавлении нового типа правил.
Нагрузочное тестирование runtime‑эндпоинта и кешей
Runtime‑эндпоинт обычно самый горячий: его дергают все клиенты. Прогоняйте нагрузку на сценариях:
- холодный старт (пустые кеши),
- пик обновлений (частые изменения флагов),
- деградация хранилища (замедление/таймауты).
Отдельно проверьте поведение кешей: TTL, инвалидирование по версии конфигурации, защита от «thundering herd».
Миграции схемы без поломок
Флаги живут годами, поэтому миграции неизбежны. Правило: новые типы правил и поля добавляйте backward‑compatible.
- Версионируйте формат конфигурации.
- Делайте двухфазные изменения: сначала запись в новом формате, потом чтение.
- Валидацию схемы запускайте в CI и при сохранении в админке.
План деплоя: blue/green и быстрый откат
Сервис флагов лучше деплоить по blue/green: две версии работают параллельно, трафик переключается постепенно.
Откат должен быть не только «кодовый», но и конфигурационный: храните версии конфигов и разрешите откат по номеру версии/времени (без ручного редактирования правил).
Если вы собираете сервис на TakProsto.AI, удобно использовать снапшоты и откат как для конфигураций, так и для приложения целиком: это дополняет kill switch на уровне флагов и ускоряет восстановление после неудачных изменений.
Резервное копирование и восстановление
Бэкапы конфигураций делайте регулярно и автоматически. Проверьте восстановление на практике: как быстро поднять чистую инсталляцию и вернуть актуальные флаги, кто имеет право запускать процедуру, и как убедиться, что восстановлена именно нужная версия.
Если хотите, полезно закрепить эти процедуры в коротком runbook рядом с /blog/feature-flags-observability (или вашим разделом про наблюдаемость), чтобы дежурные не искали знания по чатам.
Процессы и гигиена фичефлагов: чтобы система не разрослась
Технически фичефлаги можно сделать быстро. Но без правил они превращаются в «кладбище переключателей», где никто не помнит, что можно выключать, а что держит оплату. Поэтому рядом с кодом нужны простые процессы.
Стандарты именования и структура
Договоритесь об одном формате и зафиксируйте его в гайдлайне в админке.
- Префиксы по области:
billing.*,ui.*,search.*,onboarding.*— по ним удобно фильтровать и назначать владельцев. - Оговорите семантику:
enable_…для включения фичи,kill_…для аварийного отключения,exp_…для экспериментов. - Теги: команда, продуктовая инициатива, платформа, срочность (например,
team-payments,q1-2026).
Политика жизненного цикла
У каждого флага должен быть статус и владелец.
- Owner обязателен (команда или конкретный ответственный).
- Архивация вместо удаления: сначала «Archived» (нельзя использовать в новых правилах), потом удаление по регламенту.
- Срок жизни: для временных флагов задавайте дату, когда он должен быть выключен или удалён.
Документирование, которое реально читают
В карточке флага сделайте поля обязательными: краткое описание, ожидаемый эффект (что изменится для пользователя/метрик), ссылка на задачу, дата ревизии/отключения. Это снижает риск случайно тронуть продакшен и облегчает передачу между командами.
Регулярная «гигиена флагов»
Поставьте календарную ревизию (например, раз в две недели):
- флаги без владельца/описания — в карантин;
- флаги с истёкшим дедлайном — на удаление или продление с причиной;
- экспериментальные — закрыть результатом (выкатили/откатили) и убрать.
Когда выгоднее взять готовое решение
Разработка своего сервиса оправдана не всегда. Выбирайте готовый продукт, если важны: быстрый старт, поддержка, продвинутый аудит, готовые SDK, сегментация и эксперименты, соответствие требованиям безопасности.
Если же вы хотите собственный сервис (под свои процессы и требования), но без долгого разгона команды, удобно стартовать с TakProsto.AI: собрать рабочий прототип «админка + runtime + PostgreSQL», включить режим планирования, быстро пройти несколько итераций с владельцами продукта, а затем — при необходимости — перейти на тариф Pro/Business/Enterprise, подключить деплой/хостинг и выгрузить исходники. Дополнительно можно получать кредиты за контент про платформу или по реферальной программе — это помогает снизить стоимость экспериментов на ранней стадии.
FAQ
Чем фичефлаг отличается от обычной конфигурации?
Фичефлаг — это переключатель, который управляет тем, выполняется ли ветка логики. Код уже может быть в продакшене, но функция станет доступна только после включения флага.
Конфигурация обычно настраивает параметры уже работающей логики (таймауты, лимиты), а флаг решает: выполнять логику вообще или нет.
Зачем нужна раскатка, если можно просто включить фичу всем?
Раскатка (rollout) снижает риск за счёт постепенного включения:
- начинаете с 1–5% аудитории;
- следите за метриками (ошибки, латентность, конверсия);
- расширяете охват до 25% → 50% → 100%.
Если что-то пошло не так, вы останавливаете эффект на небольшой доле пользователей.
Что такое kill switch и как правильно его использовать?
Kill switch — это аварийный рубильник, который перекрывает все правила и принудительно возвращает безопасное значение (обычно off).
Практика:
- делайте его отдельным флагом или отдельным режимом флага;
- ограничьте права на использование;
- фиксируйте причину в аудите (почему выключили).
Как сделать процентную раскатку «липкой» (sticky) и воспроизводимой?
Чтобы пользователь не «мигал» между вариантами, используйте детерминированное распределение:
- берёте стабильный идентификатор (например,
user_idилиorg_id); - считаете хэш от
(flag_key + stable_id); - сравниваете результат с порогом процента.
Так одни и те же пользователи будут попадать в те же 10% и завтра, и через неделю.
Что обязательно должно быть в MVP сервиса фичефлагов?
Минимальный MVP обычно включает:
- типы флагов:
booleanиmultivariate; - правила: всем/никому, процент, список пользователей/организаций;
- UI: список флагов, карточка флага, редактор правил, история изменений;
- аудит и роли хотя бы для prod.
Главная цель MVP — безопасно снижать релизный риск и быстро откатывать изменения без деплоя.
Какая модель данных чаще всего подходит для флагов и окружений?
Полезная базовая модель:
- Project — приложение/система;
- Environment — dev/stage/prod (настройки раздельно);
- FeatureFlag — ключ, описание, владелец;
- Rules/Variants — правила таргетинга и варианты значений на уровне окружения.
Разнос по окружениям защищает от случайного переноса тестовых правил в продакшен.
Почему стоит разделять admin и runtime контуры в архитектуре?
Два контура упрощают и безопасность, и производительность:
- Admin: CRUD, валидации, RBAC, аудит, частые записи.
- Runtime: почти только чтение, низкая задержка, высокая нагрузка.
Практично: одно хранилище правил + отдельный runtime-эндпоинт, который отдаёт готовые вычисленные значения, а не «сырые» правила.
Как организовать кеш и fallback, чтобы флаги не ломали работу приложения?
Чтобы флаги не тормозили приложение:
- используйте SDK с локальным кэшем (память + опционально диск);
- задайте таймауты на обновление (особенно на фронтенде);
- при недоступности runtime возвращайте «последнее известное» или дефолт.
Не делайте получение флагов блокирующим для критичного пользовательского потока.
Какие роли и права доступа нужны, чтобы безопасно менять продакшен?
Минимально полезный RBAC:
- Viewer — просмотр;
- Editor — правки в dev/stage;
- Release manager — изменения в prod и раскатки;
- Admin — управление доступами и токенами.
Для prod добавьте предохранители: подтверждение опасных действий, обязательное поле «причина», опционально правило «четырёх глаз» (ревью второй ролью).
Какие метрики и алерты нужны для наблюдаемости фичефлагов?
Начните с того, что помогает быстро находить проблемы:
- метрики runtime: латентность, ошибки, доля фолбэков на дефолт;
- метрики по флагам: количество evaluations, распределение вариантов;
- события управления: кто/когда изменил процент, правила, включил kill switch.
Хорошее правило алерта: «после изменения флага выросли ошибки/латентность» и «резко увеличилась доля фолбэков из-за недоступности runtime».